演示数据与计算方法
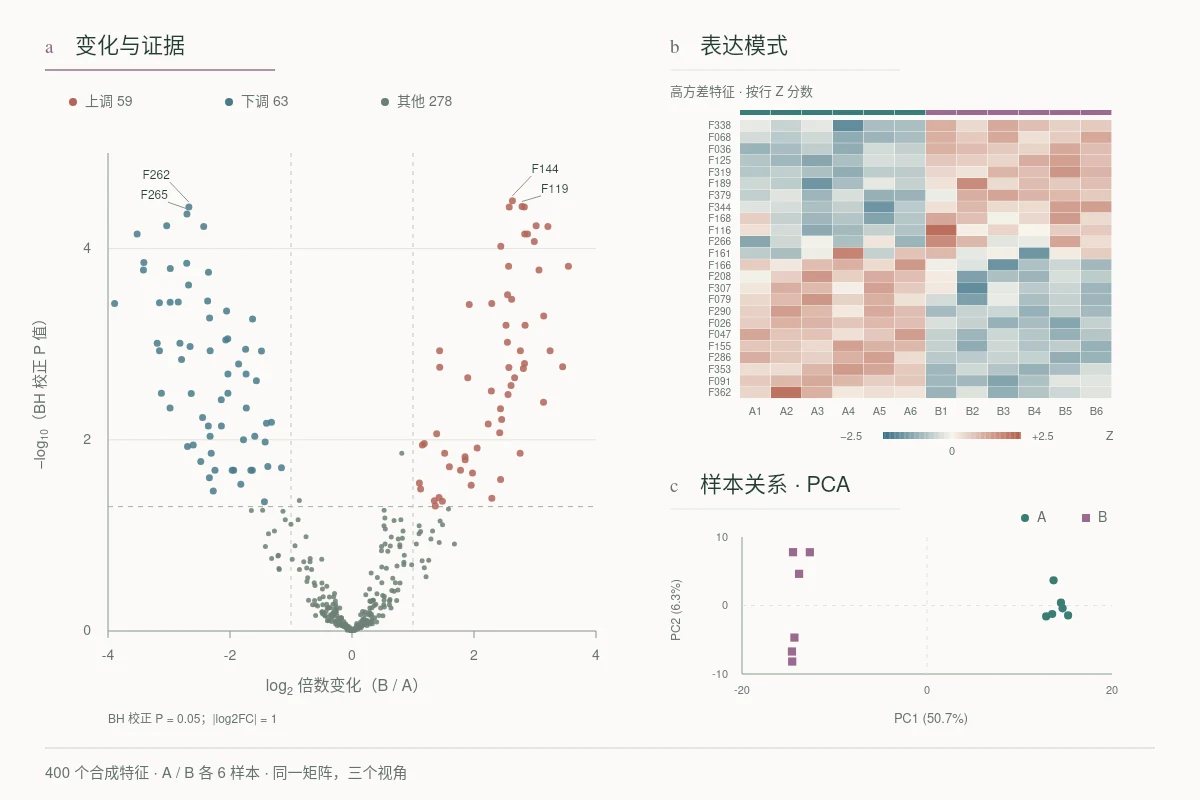
首页的火山图、热图与 PCA 来自同一份 400 × 12 合成表达矩阵。以下说明对应图中的实际计算口径;所有数据仅作演示,不代表真实实验结论。
输入:同一份表达矩阵
随机种子为 20261010。矩阵包含 400 个抽象特征,A、B 两组各 6 个样本,共 12 列样本。输入已经是归一化后的 log₂ 表达值,不是 RNA-seq 原始计数,也没有对应真实基因或通路。
火山图:变化幅度与统计证据
每个特征采用双侧 Welch t 检验比较两组,再用 Benjamini–Hochberg(BH)方法进行多重检验校正。横轴 log₂FC 为 B 组均值减 A 组均值,纵轴为 −log₁₀(BH 校正 P 值)。同时满足 BH 校正 P < 0.05 与 |log₂FC| ≥ 1 的点着色。
热图:高变特征的表达模式
选择方差最高的 24 个特征,逐行使用样本标准差计算 Z 分数。行使用欧氏距离、平均连接法聚类,列保持 A、B 分组顺序。色阶限制在 −2.5 至 +2.5;超出范围的值以端点颜色显示。
PCA:样本之间的关系
使用全部 400 个特征。按特征中心化,不做方差标准化,再用奇异值分解(SVD)计算主成分及解释方差。横纵轴对应 PC1、PC2;轴上的百分比表示各主成分解释的方差比例。
如何理解这些图
三种图形使用同一份合成矩阵,分别展示组间变化、表达模式与样本关系。它们用于说明图表制作能力,不支持真实生物学结论。这里没有进行 DESeq2、UMAP 或通路富集分析。
补充:药理曲线示例
归档中的药理图版同样使用合成数据:3 组 × 9 个浓度 × 4 次重复,共 108 个值。浓度单位为 μM,横轴为对数。使用无权最小二乘拟合四参数抑制型 Logistic 模型:
Bottom + (Top − Bottom) / (1 + (c / IC50)^Hill)
IC50 对应上下平台中点的浓度,不必然是原始响应值 50%。误差线为样本标准差;残差为原始响应减拟合响应,单位为百分点。未给出置信区间或疗效结论。